GPLについて、理解が浅いと勘違いしそうな部分をまとめてみました。
<参考>
https://www.gnu.org/licenses/gpl-faq.ja.html
http://www.itmedia.co.jp/enterprise/articles/0504/29/news003.html
■再配布について
複製、再配布が可能。
再配布するときは、ソースコードと実行モジュールのセットでなければならず、
実行モジュールだけの再配布はできないということです。
ここで、もうひとつ大事なことは、GPLでライセンスされたものを、
他のライセンスに変えることはできないということ。
他のライセンスに変えると、著作権違反で訴えられる可能性がでてきます。
(著作権についてを参考にしてください。)
■公開について
必ず広く不特定多数の人に公開しなければならないわけではない。
公開するかどうかは、自由に決められるということです。
ただし、公開するときはソースコードと実行モジュールのセットで公開しなければならず、実行モジュールだけの公開はできません。
■有償、無償について
日本では、オープンソースは無料というイメージが強いが、
GPLに関しては無償でなければならないという定義はまったくなく、
有償でもライセンスには抵触しません。
オープンソースソフトウェアをどうマネタイズするかは、ソフト自体を有償にする方法もあるが、他のいろいろな方法もあります。
■LGPL
主にライブラリとして扱われるプログラムに付与されるライセンス。
たとえば、ある暗号化プログラムAがLGPLだったとします。
このプログラムAを利用して、通信ソフトBを作成したとします。
この場合、通信ソフトBは、プログラムAをライブラリとして使っているだけであれば
通信ソフトBのプログラムの公開や配布をする必要はなく、通信ソフトBをGPL以外の独自のライセンスとすることもできます。
■Webサイトでの公開とAGPL
AGPLと新たなライセンスについてです。
オープンソースのWebプログラムで、Webサイトのすべてのプログラムがオープンソースであるとき、そのプログラムを改変した第三者が改変したプログラムでデモサイトを公開したとします。
この場合、Webサイトが実行モジュールと考えられるが、その実行モジュールを配布しているわけではなく、プログラムを配布する必要はないとされているし、時代的な背景もあって、GPL2は、Webサイトのような仕組みを規定していません。
ただし、AGPLとしては、この部分の規定が明記され、デモサイトを公開しただけでも
ソースの公開が必要となるようで、非常に厳しいライセンス体系となっています。
■GPL2とGPL3について
GPL2とGPL3の大きな違いは、特許についてのようです。
GPL2では、特許についての言及はないが、GPL3では、特許について言及されています。
詳細については、下記、著作権についてのあとで、特許権についてで記述します。
■著作権について
GPLの著作権については少々難しいです。
まず、GPLに関係なくプログラムの著作者には、自動的に著作権が与えられます。
なので、他人がつくったプログラムを勝手に複製、改変すると著作権侵害になります。
これに対して、GPLでは、複製や改変をしても著作権侵害になりません。
ただ、注意しなければいけないのは、GPLが著作権を放棄しているわけではないということです。
どういうことかというと、もし、他人がつくったGPLのプログラムを勝手に複製、改変して、GPLを受け入れなければ、つまり違うライセンスにするなどすれば、
著作権で訴えられる可能性がでてくるということです。
著作権侵害になりたくなければGPLを受け入れなければなりません。
GPLを受け入れた場合のみ、自由にプログラムの複製、改変、再配布が可能で、受け入れなければ著作権侵害となるということのようです。
つまり、GPLが著作権を放棄しているわけではありません。
■特許権について
まず、特許権について言及されているのは、GPL3からです。
そして、特許権についても、著作権と似たような考え方のようです。
(私は、法律家でないので、各自で詳細は確認してください。)
GPL3が特許権を放棄しているわけではなく、
GPL3を受けいれた場合のみ、特許権侵害で訴えることはないですよ、
もし、受け入れなければ、特許権侵害になりますよということのようです。
■サブスクリプションによるマネタイズ
マネタイズについては、いろいろあるがサブスクリプションによるマネタイズが最も成功したモデルのひとつといえます。
基本的には、サポート契約として年間サポート料によって収入を得ます。
プログラムは、複製、再配布が可能だが、プログラム内に商標つきのロゴを含めていたりします。
そのため、再配布をおこなう場合は、そのロゴを入れ替えて再配布する必要があります。
これは、ロゴを入れ替えずに再配布すると、ユーザがそのプログラムの作成者を誤認する可能性があるため
ロゴを入れ替えて再配布することを義務付けているようです。
一方で、ロゴを入れ替えるためには、技術的な知識が必要なため、
プログラムを入手したものが誰しもこのプログラムを再配布して新たなマネタイズを試みることは難しいといえます。
仮に、技術を持っていたとしても、後発のディスアドバンテージがあったり、
結局、そのプログラムをどれだけ知っているかがビジネスのコアコンピタンスとなり、オープンソースに対する知識・経験が勝負の決め手になるといえます。
2018年5月27日日曜日

2017年10月17日火曜日
ADempiereのJasperで使うImageのパス
■Jasper内で使うイメージのファイルパス
JasperReportで、静的イメージファイルを貼り付けたときに注意することとして
そのイメージのパスの問題がある。
通常、JasperReportをデザインするのは、iReportというツールを使う。
iReportで、静的イメージを貼り付けるには、パレットからImageオブジェクトを選択して
デザイン中のレポートへドラッグすることで貼り付けることができる。
このときに、ダイアログが出て、静的ファイルを選択することとなる。
しかし、この動作によって、設定されるファイルパスは、使用中のiReportがある環境でのファイルパスとなる。
つまり、このJasperReportとImageファイルをサーバなどへ配置した場合、ここで設定されたパスでは、Imageファイルが見つからないことになってしまうことも多く、最終的な実行環境を想定したパスをここで設定しておかなければならない。
■ADempiereでのJasperイメージパスの設定方法
ADempiereでは、AP辞書で登録したJasperファイルやイメージファイルをReportStarterというクラスが処理して、JasperReportのアウトプットを作成する。
このときに、使用されるパスは、以下のようになる。
System.getProperty("java.io.tmpdir") + System.getProperty("file.separator")+"ABCDEFG.png"
つまり、システムプロパティの「java.io.tmpdir」に、Jasper関連のファイルが一時保存されて使用されている。
(C:\Users\ユーザ名\AppData\Local\Temp)
なので、iReportでデザインするときに、ImageオブジェクトのImageExpressionプロパティにも、上記のパスを設定しておけば、ADempiereでうまく表示することができる。
JasperReportで、静的イメージファイルを貼り付けたときに注意することとして
そのイメージのパスの問題がある。
通常、JasperReportをデザインするのは、iReportというツールを使う。
iReportで、静的イメージを貼り付けるには、パレットからImageオブジェクトを選択して
デザイン中のレポートへドラッグすることで貼り付けることができる。
このときに、ダイアログが出て、静的ファイルを選択することとなる。
しかし、この動作によって、設定されるファイルパスは、使用中のiReportがある環境でのファイルパスとなる。
つまり、このJasperReportとImageファイルをサーバなどへ配置した場合、ここで設定されたパスでは、Imageファイルが見つからないことになってしまうことも多く、最終的な実行環境を想定したパスをここで設定しておかなければならない。
■ADempiereでのJasperイメージパスの設定方法
ADempiereでは、AP辞書で登録したJasperファイルやイメージファイルをReportStarterというクラスが処理して、JasperReportのアウトプットを作成する。
このときに、使用されるパスは、以下のようになる。
System.getProperty("java.io.tmpdir") + System.getProperty("file.separator")+"ABCDEFG.png"
つまり、システムプロパティの「java.io.tmpdir」に、Jasper関連のファイルが一時保存されて使用されている。
(C:\Users\ユーザ名\AppData\Local\Temp)
なので、iReportでデザインするときに、ImageオブジェクトのImageExpressionプロパティにも、上記のパスを設定しておけば、ADempiereでうまく表示することができる。
2017年7月26日水曜日
ADempiereのIEブラウザ対応
ADempiereは、FireFoxやChromeには対応しており問題なく動作するが
IEとなると少し問題がある。
グリッド表示やテキストボックスの表示がおかしくなったり、画面が真っ白になってしまうことがある。
ただし、これは、コミュニティ版のADempiereの場合で、SMBアソシエイツ社では、IEでも問題なく正常動作するように修正を加えている。
ADempiereをIEで正常動作させるためには、以下の対応が必要となる。
■Compatible対応のヘッダー出力をしない
WebUIプロジェクトのindex.zulで、IE8へのCompatible対応タグが記述されているので、これを削除する。
具体的には、index.zulの7行目あたりの以下の部分を削除する。
<?meta http-equiv="X-UA-Compatible" content="IE=8" ?>
■拡大、縮小時のエラー対応
上記の対応をすれば、IEでもほぼほぼ正常動作が可能になるが
Ctrl+マウスホイールを使った拡大縮小時にエラーが発生してしまう。
これに対応するには、以下のソースの修正が必要である。
zk.jarの中にある「MouseCommand.java」に以下の修正をおこなう。
processメソッドの中で、NumberForamtExceptionが発生しないように対処をおこなっている。
// SMBA_CHG IE対応(NumberFormatExceptionの回避)
MouseEvent event = null;
if( data == null || data.length == 0 )
{
event = new MouseEvent(getId(), comp); //no area, no coord
}
else if( data.length == 1 )
{
event = new MouseEvent(getId(), comp, data[0]); //by area
}
else
{
BigDecimal bdVal1 = new BigDecimal(data[0]);
BigDecimal bdVal2 = new BigDecimal(data[1]);
event = new MouseEvent(getId(), comp, //by coord
bdVal1.intValue(), bdVal2.intValue(),
data.length < 3 ? 0: Commands.parseKeys(data[2]));
}
// final MouseEvent event =
// data == null || data.length == 0 ?
// new MouseEvent(getId(), comp): //no area, no coord
// data.length == 1 ?
// new MouseEvent(getId(), comp, data[0]): //by area
// new MouseEvent(getId(), comp, //by coord
// Integer.parseInt(data[0]), Integer.parseInt(data[1]),
// data.length < 3 ? 0: Commands.parseKeys(data[2]));
// CHG_END
ちなみに、zk.jarは、通常はjarとして参照していることが多いが、ZK関連のjarもEclipseプロジェクト化しておくと、デバッグができるので便利である。


■メッセージの非表示
最後に、ログインページで表示されるメッセージを非表示にする。
IEでログインページにアクセスすると、「一部機能が正常に動作しない可能性がある」という旨のメッセージが表示されてしまう。
これを表示しないようにしておくには、webuiプロジェクトのWLogin.javaを修正する。
81行目あたりでメッセージを表示している部分を削除しておく。
/*
if (!AEnv.isBrowserSupported())
{
// String msg = "You might experience slow performance and user interface anomalies using your current browser to access the application. We recommend the use of Firefox, Google Chrome or Apple Safari.";
String msg = "You might experience slow performance and user interface anomalies using your current browser to access the application. We recommend the use of Firefox, Google Chrome or Apple Safari."
+ "<BR>現在のブラウザはADempiereの一部機能が正常に動作しない可能性があります。ADempiereのすべての機能を使用するにはFirefoxやGoogle ChromeまたはSafariなどのブラウザをお勧めします。";
browserWarningWindow = new Window();
Div div = new Div();
div.setStyle("background-color:#FFFFCC; font-size: " + (AEnv.getFontSize() - 1) + "pt");
div.appendChild(new Text(msg));
browserWarningWindow.appendChild(div);
browserWarningWindow.setPosition("top,right");
browserWarningWindow.setWidth("550px");
browserWarningWindow.setPage(page);
browserWarningWindow.doOverlapped();
}
*/
これらの対応をしておけば、ADempiereにInternet Explorerでアクセスしても、正常に動作させることが可能である。
2017年7月25日火曜日
ADempiereのトランザクションとコネクション
ADempiereでは、基本的には、プロセスクラスがひとつのトランザクションクラスを保持し、
トランザクションクラスがひとつのコネクションを保持するという関係になっている。
プロセスクラスでひとつだけのトランザクションを使用する場合においては
プロセスクラスがトランザクションとコネクションを管理してくれるようになっている。

例外的には、スレッドなどを使うために、プロセスクラスで複数のトランザクションを使用する場合がある。この場合は、プロセスクラスに依存せず、トランザクションやコネクションの管理を適切におこなう必要がある。
プロセスクラスでひとつのトランザクションを使用する場合においては
プロセスクラスがトランザクションとコネクションを管理してくれるので
(プロセス開始時にトランザクション開始して、プロセス終了時にトランザクションを終了)
複数のトランザクションを使用しない限り、コミット漏れなどを気にする必要はないように見える。
注意が必要なのは、以下に説明するModelクラスを使用する場合とDB.javaのstaticメソッドを使用する場合である。
■Modelクラスとトランザクション
Modelクラスでのトランザクション管理は、少し複雑であるが
大きく分類すると
Modelクラスでトランザクションを作成してクローズするのか、
Modelクラスにトランザクションを外から渡し、トランザクション管理は呼び出し側でおこなうという2通りがある。
<Modelクラスにトランザクションを外から渡す場合>

まず、Modelクラスにトランザクションを外から渡す場合である。
ADempiereでは、通常このパターンでModelクラスを運用することが多いと思われる。
これは、Modelクラスをインスタンス化するときに、以下のようにトランザクション名を渡すことで、
Modelクラスに外からトランザクションを渡せるようになる。
MPPOrder ppOrder = new MPPOrder(getCtx(), 0, get_TrxName());
通常は、Processクラスのget_TrxName()メソッドを使用して、プロセスクラスが保持しているトランザクションをそのまま渡すことで、ProcessクラスとModelクラスとのトランザクションを統一している。
この場合、Modelクラスのsave()メソッドを呼び出しても、コミットやトランザクションのクローズはされず、これらは呼出元に任されることになる。
つまり、呼出元で必ずコミットやクローズをするようにしないとトランザクションが残ってしまう。
☆呼出元でトランザクション管理をすることが必須となるので注意が必要。(プロセスクラスからの呼び出しであればプロセスクラスがやってくれる。)
また、この場合、エラーがおこったとき、ロールバックはされないが、SavePointを使用して、このModelクラスでおこなった更新処理だけを元に戻すようになっている。
<Modelクラスにトランザクションを外から渡さない場合>

Modelクラスにトランザクションを渡さない場合は、Modelクラス内部で新しいトランザクションが作成される。また、トランザクションは、Modelクラス内でコミットまたはロールバックがおこなわれ、クローズまでされる。Modelクラスないだけで利用されるいわゆるローカルトランザクションとなる。
■DB.javaのStaticメソッドとトランザクション
DB.javaでは、SQLを単発的に実行できるStaticメソッドがたくさん定義されている。
これらのメソッドでも、トランザクション名を外から渡せるようになっており
Modelクラスと同様に、トランザクションを外から渡すか、内部で作成するかを選ぶことができる。
ただ、コミュニティ版のDB.javaでは、コネクションのクローズ漏れがあり
これらのメソッドに、トランザクション名をNullで渡すと、コネクションが残ってしまう。
SMBアソシエイツ社では、これらのDB.javaのStaticメソッドのコネクション漏れを修正している。
また、さらに、SMBアソシエイツ社では、複数トランザクションの実装やコネクションプールを使わない選択ができるようにプロセスクラスを改造している。
トランザクションクラスがひとつのコネクションを保持するという関係になっている。
プロセスクラスでひとつだけのトランザクションを使用する場合においては
プロセスクラスがトランザクションとコネクションを管理してくれるようになっている。

例外的には、スレッドなどを使うために、プロセスクラスで複数のトランザクションを使用する場合がある。この場合は、プロセスクラスに依存せず、トランザクションやコネクションの管理を適切におこなう必要がある。
プロセスクラスでひとつのトランザクションを使用する場合においては
プロセスクラスがトランザクションとコネクションを管理してくれるので
(プロセス開始時にトランザクション開始して、プロセス終了時にトランザクションを終了)
複数のトランザクションを使用しない限り、コミット漏れなどを気にする必要はないように見える。
注意が必要なのは、以下に説明するModelクラスを使用する場合とDB.javaのstaticメソッドを使用する場合である。
■Modelクラスとトランザクション
Modelクラスでのトランザクション管理は、少し複雑であるが
大きく分類すると
Modelクラスでトランザクションを作成してクローズするのか、
Modelクラスにトランザクションを外から渡し、トランザクション管理は呼び出し側でおこなうという2通りがある。
<Modelクラスにトランザクションを外から渡す場合>

まず、Modelクラスにトランザクションを外から渡す場合である。
ADempiereでは、通常このパターンでModelクラスを運用することが多いと思われる。
これは、Modelクラスをインスタンス化するときに、以下のようにトランザクション名を渡すことで、
Modelクラスに外からトランザクションを渡せるようになる。
MPPOrder ppOrder = new MPPOrder(getCtx(), 0, get_TrxName());
通常は、Processクラスのget_TrxName()メソッドを使用して、プロセスクラスが保持しているトランザクションをそのまま渡すことで、ProcessクラスとModelクラスとのトランザクションを統一している。
この場合、Modelクラスのsave()メソッドを呼び出しても、コミットやトランザクションのクローズはされず、これらは呼出元に任されることになる。
つまり、呼出元で必ずコミットやクローズをするようにしないとトランザクションが残ってしまう。
☆呼出元でトランザクション管理をすることが必須となるので注意が必要。(プロセスクラスからの呼び出しであればプロセスクラスがやってくれる。)
また、この場合、エラーがおこったとき、ロールバックはされないが、SavePointを使用して、このModelクラスでおこなった更新処理だけを元に戻すようになっている。
<Modelクラスにトランザクションを外から渡さない場合>

Modelクラスにトランザクションを渡さない場合は、Modelクラス内部で新しいトランザクションが作成される。また、トランザクションは、Modelクラス内でコミットまたはロールバックがおこなわれ、クローズまでされる。Modelクラスないだけで利用されるいわゆるローカルトランザクションとなる。
■DB.javaのStaticメソッドとトランザクション
DB.javaでは、SQLを単発的に実行できるStaticメソッドがたくさん定義されている。
これらのメソッドでも、トランザクション名を外から渡せるようになっており
Modelクラスと同様に、トランザクションを外から渡すか、内部で作成するかを選ぶことができる。
ただ、コミュニティ版のDB.javaでは、コネクションのクローズ漏れがあり
これらのメソッドに、トランザクション名をNullで渡すと、コネクションが残ってしまう。
SMBアソシエイツ社では、これらのDB.javaのStaticメソッドのコネクション漏れを修正している。
また、さらに、SMBアソシエイツ社では、複数トランザクションの実装やコネクションプールを使わない選択ができるようにプロセスクラスを改造している。
ADempiereのヒープメモリの設定
ADempiereのヒープメモリの設定について、どのくらいが適切なのか
もちろん、潤沢なメモリ環境であれば、できるだけ多く設定しておいたほうが間違いないが
弊社で把握しているヒープメモリの設定状況について記述したい。
まず、ヒープ全体について、特にMRPなどの負荷の高い処理を行う場合は、最低4GB、できれば6GB以上あったほうがベターである。
Javaの起動オプションは以下で指定する。
-Xms6144M -Xmx6144M
次にヒープメモリの内訳について、
■Permanent領域
まず指定しやすいのは、Permanentメモリサイズである。
これは、クラス定義のような一度メモリ登録すれば書き換わることのないであろうデータを登録する領域である。
ADempiereの場合、クラスが多いので通常のアプリケーションよりもこのサイズは、大きいほうがベターであるが、それでも256MBもあれば十分である。これでも、使用率が30%を超えることはないと考えられる。
Javaの起動オプションは以下で指定する。
-XX:PermSize=256M -XX:MaxPermSize=256M
■New領域
New領域とは、クラスをNewしたときに格納される領域である。クラスがNewされると、まずはEden領域というところに格納され、YoungGCまたはFullGCによって、Eden領域からSurvivor領域に移動されるか解放される。
このNew領域が小さければ、YoungGCが頻繁に走ってしまい、処理落ちを起こす原因となってしまう。
また、ADempiereの場合、Newされるオブジェクトが多いが、すぐに解放されることが多いので
New領域を多めにとって、Old領域を少なめにしても、よほど下手なプログラムを記述しない限り、FullGCが頻発することは考えにくい。
よって、7割から8割をNew領域に割り当てて問題ないといえる。
この設定でも、ある案件で実運用と同様のオーダー数のMRPを回した後でも、Old領域は1割程度の使用率である。
Javaの起動オプションは以下で指定する。
-XX:NewSize=4096M -XX:MaxNewSize=4096M
<Survivor領域>
Survivor領域とは、Eden領域のうち、GCによって解放されなかったオブジェクトが格納される領域である。
このSurvivor領域とEden領域の割合を起動オプションで設定できるが、これを変えても大きな変化は見られなかった。
理由の推測としては、この割合を変えても、New領域全体が変わるわけではないので、YGCの頻度も変わらないから当然と思われる。
よって、これは、デフォルトでいいと考えられる。
もし、設定する場合、Javaの起動オプションは以下で指定する。
-XX:SurvivorRatio=2
■Old領域
Old領域は、Survivor領域で、何度も解放されなかったオブジェクトおよび、Survivor領域がいっぱいになったときのオブジェクトが移動される領域である。
この領域がいっぱいになると、FullGCが発生し、何度もいっぱいになると、FullGCが頻発することになるのが、上記でも説明したとおり、ADempiereでは、Old領域に大きなサイズが必要ということにはなりにくいため、ヒープ全体の2割から3割でいいと考えられる。
Javaの起動オプションは特に指定しない。(NewRatioで設定もできるが、全体から、パーマネントとNew領域をひいたサイズとなるため。)
■ヒープ設定例(全体を6GBとしたとき)
-Xms6144M -Xmx6144M -XX:PermSize=256M -XX:MaxPermSize=256M -XX:NewSize=4096M -XX:MaxNewSize=4096M
※もう少し、New領域を増やしてもよいが、ちまたのベストプラクティス(New:Old=1:2)と乖離しすぎるので・・・。
※32ビットOSでは、2GBまでなので注意。
※起動オプションのgcInterval指定について不要という人もいるが、個人的にはあったほうがいいと思っている。1時間に1回ぐらいは、FullGCされてもいいかなと思うし、逆にこれをせずにメモリオーバーフローになるほうが怖いと思う。(gcInterval=3600000)
もちろん、潤沢なメモリ環境であれば、できるだけ多く設定しておいたほうが間違いないが
弊社で把握しているヒープメモリの設定状況について記述したい。
まず、ヒープ全体について、特にMRPなどの負荷の高い処理を行う場合は、最低4GB、できれば6GB以上あったほうがベターである。
Javaの起動オプションは以下で指定する。
-Xms6144M -Xmx6144M
次にヒープメモリの内訳について、
■Permanent領域
まず指定しやすいのは、Permanentメモリサイズである。
これは、クラス定義のような一度メモリ登録すれば書き換わることのないであろうデータを登録する領域である。
ADempiereの場合、クラスが多いので通常のアプリケーションよりもこのサイズは、大きいほうがベターであるが、それでも256MBもあれば十分である。これでも、使用率が30%を超えることはないと考えられる。
Javaの起動オプションは以下で指定する。
-XX:PermSize=256M -XX:MaxPermSize=256M
■New領域
New領域とは、クラスをNewしたときに格納される領域である。クラスがNewされると、まずはEden領域というところに格納され、YoungGCまたはFullGCによって、Eden領域からSurvivor領域に移動されるか解放される。
このNew領域が小さければ、YoungGCが頻繁に走ってしまい、処理落ちを起こす原因となってしまう。
また、ADempiereの場合、Newされるオブジェクトが多いが、すぐに解放されることが多いので
New領域を多めにとって、Old領域を少なめにしても、よほど下手なプログラムを記述しない限り、FullGCが頻発することは考えにくい。
よって、7割から8割をNew領域に割り当てて問題ないといえる。
この設定でも、ある案件で実運用と同様のオーダー数のMRPを回した後でも、Old領域は1割程度の使用率である。
Javaの起動オプションは以下で指定する。
-XX:NewSize=4096M -XX:MaxNewSize=4096M
<Survivor領域>
Survivor領域とは、Eden領域のうち、GCによって解放されなかったオブジェクトが格納される領域である。
このSurvivor領域とEden領域の割合を起動オプションで設定できるが、これを変えても大きな変化は見られなかった。
理由の推測としては、この割合を変えても、New領域全体が変わるわけではないので、YGCの頻度も変わらないから当然と思われる。
よって、これは、デフォルトでいいと考えられる。
もし、設定する場合、Javaの起動オプションは以下で指定する。
-XX:SurvivorRatio=2
■Old領域
Old領域は、Survivor領域で、何度も解放されなかったオブジェクトおよび、Survivor領域がいっぱいになったときのオブジェクトが移動される領域である。
この領域がいっぱいになると、FullGCが発生し、何度もいっぱいになると、FullGCが頻発することになるのが、上記でも説明したとおり、ADempiereでは、Old領域に大きなサイズが必要ということにはなりにくいため、ヒープ全体の2割から3割でいいと考えられる。
Javaの起動オプションは特に指定しない。(NewRatioで設定もできるが、全体から、パーマネントとNew領域をひいたサイズとなるため。)
■ヒープ設定例(全体を6GBとしたとき)
-Xms6144M -Xmx6144M -XX:PermSize=256M -XX:MaxPermSize=256M -XX:NewSize=4096M -XX:MaxNewSize=4096M
※もう少し、New領域を増やしてもよいが、ちまたのベストプラクティス(New:Old=1:2)と乖離しすぎるので・・・。
※32ビットOSでは、2GBまでなので注意。
※起動オプションのgcInterval指定について不要という人もいるが、個人的にはあったほうがいいと思っている。1時間に1回ぐらいは、FullGCされてもいいかなと思うし、逆にこれをせずにメモリオーバーフローになるほうが怖いと思う。(gcInterval=3600000)
Postgresで現在の接続数を確認する
■現在、接続されているConnectionを確認するには
「pg_stat_activity」というテーブルを確認するとよい。
SELECT * FROM pg_stat_activity
ここに登録されているレコード1件ずつが現在接続されているConnectionである。
レコードが100件あったら、現在接続されているConnection数は、100ということになる。
■実行中のトランザクションを確認するには
上記「pg_stat_activity」テーブルの「xact_start」列が入っている場合は、そのコネクションでトランザクションが実行されている状態。

もし、実行プログラムが終了しているのに、この列に値が入っているような場合は、コミット漏れのトランザクションがある可能性があるので注意が必要。
特に、コミット漏れが原因で、他のトランザクションのレスポンスが著しく遅くなる場合があるのでコミット漏れがないかは、確実にチェックしておいたほうがいいと思われる。
ちなみに、上記のQuery列に「SHOW TRANSACTION ISOLATION LEVEL」で表示されるのは、コネクションプールを使って接続した場合のコネクションであることが多い。
■強制的に、コネクションを切断するには
以下のコマンドを実行すればよい。
SELECT pg_terminate_backend(PID)
※PIDは、上記「pg_stat_activity」テーブルの「pid」列値を使うとよい。
※ただし、コネクションプールなどで保持されているコネクションを強制的に切断した場合は
再度、コネクションプールのコネクションでプログラムが実行された場合、当然のことながらエラーになるので注意が必要。 (このコマンドの使用は開発中の作業に限定されると思われる)
「pg_stat_activity」というテーブルを確認するとよい。
SELECT * FROM pg_stat_activity
ここに登録されているレコード1件ずつが現在接続されているConnectionである。
レコードが100件あったら、現在接続されているConnection数は、100ということになる。
■実行中のトランザクションを確認するには
上記「pg_stat_activity」テーブルの「xact_start」列が入っている場合は、そのコネクションでトランザクションが実行されている状態。

もし、実行プログラムが終了しているのに、この列に値が入っているような場合は、コミット漏れのトランザクションがある可能性があるので注意が必要。
特に、コミット漏れが原因で、他のトランザクションのレスポンスが著しく遅くなる場合があるのでコミット漏れがないかは、確実にチェックしておいたほうがいいと思われる。
ちなみに、上記のQuery列に「SHOW TRANSACTION ISOLATION LEVEL」で表示されるのは、コネクションプールを使って接続した場合のコネクションであることが多い。
■強制的に、コネクションを切断するには
以下のコマンドを実行すればよい。
SELECT pg_terminate_backend(PID)
※PIDは、上記「pg_stat_activity」テーブルの「pid」列値を使うとよい。
※ただし、コネクションプールなどで保持されているコネクションを強制的に切断した場合は
再度、コネクションプールのコネクションでプログラムが実行された場合、当然のことながらエラーになるので注意が必要。 (このコマンドの使用は開発中の作業に限定されると思われる)
2017年7月21日金曜日
ヒープの状態とGCの実行回数を表示する(備忘録)
ヒープメモリの状態とGCの実行回数を表示するコマンド
jstat -gcutil -h3 <ProcessID> <表示頻度(ms)>
ex.
jstat -gcutil -h3 4716 5000
S0 S1 E O P YGC YGCT FGC FGCT GCT
92.74 0.00 76.22 9.29 7.27 188 23.448 0 0.000 23.448
92.74 0.00 98.90 9.29 7.27 188 23.448 0 0.000 23.448
0.00 92.31 23.16 9.29 7.27 189 23.630 0 0.000 23.630
<各列の説明>
S0:S0領域の使用率(Young領域)
S1:S1領域の使用率(Young領域)
E :Eden領域の使用率(Young領域)
O :Old領域の使用率(Old領域)
P :Permanent領域の使用率(永続領域)
YGC:YoungGCの発生回数
YGCT:YoungGCの処理時間(秒)
FGC:FullGCの発生回数
FGCT:FullGCの処理時間(秒)
GCT:YoungGCとFullGCの処理時間(秒)
<ヒープの世代>
■Young領域
S0,S1,EdenがYoung領域(Newされてからまだ若いヒープ)
Eden: Newがおこなわれるとまずここにたまる。
S0: Edenから少し年をとったヒープ
S1: Edenから少し年をとったヒープ
■Old領域
Young領域にある間に、解放されることがなかったヒープ。
Young領域から、Old領域に移動するタイミングは、YoungGCの回数やS0,S1領域が満杯になったときなどGCアルゴリズムによる。
■Permanent領域
基本的には永続的に保持するメモリ。主にクラス定義など
<ヒープの容量を表示する>
上記のオプションの「-gcutil」を「-gc」に変えるだけでよい。
jstat -gc -h3 <ProcessID> <表示頻度(ms)>
ex.
jstat -gc -h3 4716 5000
S0C Survivor 領域 0 の現在の容量 (KB)
S1C Survivor 領域 1 の現在の容量 (KB)
S0U Survivor 領域 0 の使用量 (KB)
S1U Survivor 領域 1 の使用量 (KB)
EC Eden 領域の現在の容量 (KB)
EU Eden 領域の使用量 (KB)
OC Old 領域の現在の容量 (KB)
OU Old 領域の使用量 (KB)
PC Permanent 領域の現在の容量 (KB)
PU Permanent 領域の使用量 (KB)
YGC 若い世代の GC イベント数
YGCT 若い世代のガベージコレクション時間
FGC フル GC イベント数
FGCT フルガベージコレクション時間
GCT ガベージコレクション総時間
※S0CやS0U、ECやEUの「C」はCapacity、「U」はUsageと思われる。
http://docs.oracle.com/javase/jp/7/technotes/tools/share/jstat.html
jstat -gcutil -h3 <ProcessID> <表示頻度(ms)>
ex.
jstat -gcutil -h3 4716 5000
S0 S1 E O P YGC YGCT FGC FGCT GCT
92.74 0.00 76.22 9.29 7.27 188 23.448 0 0.000 23.448
92.74 0.00 98.90 9.29 7.27 188 23.448 0 0.000 23.448
0.00 92.31 23.16 9.29 7.27 189 23.630 0 0.000 23.630
<各列の説明>
S0:S0領域の使用率(Young領域)
S1:S1領域の使用率(Young領域)
E :Eden領域の使用率(Young領域)
O :Old領域の使用率(Old領域)
P :Permanent領域の使用率(永続領域)
YGC:YoungGCの発生回数
YGCT:YoungGCの処理時間(秒)
FGC:FullGCの発生回数
FGCT:FullGCの処理時間(秒)
GCT:YoungGCとFullGCの処理時間(秒)
<ヒープの世代>
■Young領域
S0,S1,EdenがYoung領域(Newされてからまだ若いヒープ)
Eden: Newがおこなわれるとまずここにたまる。
S0: Edenから少し年をとったヒープ
S1: Edenから少し年をとったヒープ
■Old領域
Young領域にある間に、解放されることがなかったヒープ。
Young領域から、Old領域に移動するタイミングは、YoungGCの回数やS0,S1領域が満杯になったときなどGCアルゴリズムによる。
■Permanent領域
基本的には永続的に保持するメモリ。主にクラス定義など
<ヒープの容量を表示する>
上記のオプションの「-gcutil」を「-gc」に変えるだけでよい。
jstat -gc -h3 <ProcessID> <表示頻度(ms)>
ex.
jstat -gc -h3 4716 5000
S0C Survivor 領域 0 の現在の容量 (KB)
S1C Survivor 領域 1 の現在の容量 (KB)
S0U Survivor 領域 0 の使用量 (KB)
S1U Survivor 領域 1 の使用量 (KB)
EC Eden 領域の現在の容量 (KB)
EU Eden 領域の使用量 (KB)
OC Old 領域の現在の容量 (KB)
OU Old 領域の使用量 (KB)
PC Permanent 領域の現在の容量 (KB)
PU Permanent 領域の使用量 (KB)
YGC 若い世代の GC イベント数
YGCT 若い世代のガベージコレクション時間
FGC フル GC イベント数
FGCT フルガベージコレクション時間
GCT ガベージコレクション総時間
※S0CやS0U、ECやEUの「C」はCapacity、「U」はUsageと思われる。
http://docs.oracle.com/javase/jp/7/technotes/tools/share/jstat.html
2017年7月20日木曜日
ADempiereのMRPの処理速度改善メモ
MRPの処理速度改善のために、いろいろ実装したが、スレッド化がかなり効果的だった。
1スレッドごとに16%程度の処理改善がみられたようだ。
ただし、コア数以上のスレッドでは改善率が極端に下がる。
試験環境は、6コアで、1.16の6乗=2.4363
実際には、6スレッド以上を起動しているので、2.4倍以上の速さになることを確認。
そこそこの部品構成と需要件数でも、30分で処理が終わるMRPになった。
技術的には、スレッドごとにレコードロックが競合しないように設計すること、こまめにコミットしてレコードロックを長時間保持しないこと、Wait、Notifyを巧みに使用すること、トランザクションのコミット漏れや長時間トランザクション、コネクション数のケア、Postgresのデッドタプル、オートバキューム実行ログのチェックなどがポイントだったように思う。
1スレッドごとに16%程度の処理改善がみられたようだ。
ただし、コア数以上のスレッドでは改善率が極端に下がる。
試験環境は、6コアで、1.16の6乗=2.4363
実際には、6スレッド以上を起動しているので、2.4倍以上の速さになることを確認。
そこそこの部品構成と需要件数でも、30分で処理が終わるMRPになった。
技術的には、スレッドごとにレコードロックが競合しないように設計すること、こまめにコミットしてレコードロックを長時間保持しないこと、Wait、Notifyを巧みに使用すること、トランザクションのコミット漏れや長時間トランザクション、コネクション数のケア、Postgresのデッドタプル、オートバキューム実行ログのチェックなどがポイントだったように思う。
2017年1月11日水曜日
Postgresチューニングパラメータ(主なもの)
Postgresのチューニングパラメータの備忘録。(9.3ベースの設定ファイル)
postgres.confで設定される。
多くのPostgresのチューニングパラメータは、一昔前のPCを意識したような設定値であり、
最近のPCスペックにあった設定をしておいたほうがいい。
■メモリ関連
☆shared_buffers = 2048MB # min 128kB
# (change requires restart)
表領域をキャッシュする領域。
たとえば、SELECTを実行するときに、この領域にデータがあれば
ディスクアクセスせずここのデータを読み書きする。
ディスクアクセス回数を減らすことができれば、処理が速くなる。
OSキャッシュとの兼ね合いもあるので、あまり大きくすることは推奨されない。
実メモリの25%がいいといわれている。
また、指定方法は古いバージョンではバッファ指定だったが、
最近のバージョンでは、バッファ指定できないようだ。
GB、MB、kBの単位で設定するようにする。
☆work_mem = 1MB # min 64kB
Postgresが処理に使うワーキングメモリ。
(実メモリ-shared_buffers)/max_connectionsを超えるとスワップするので注意。
☆maintenance_work_mem = 16MB # min 1MB
バキュームなどのメンテナンス処理に使われるワーキングメモリ。
少なすぎると、バキュームされないことがあるという人もいるが詳細不明。
■コネクション関連
☆max_connections = 300
work_memとの関係に注意。
work_memは接続ごとに発生するので、work_mem*max_connectionsのメモリを確保しておかないと、スワップ発生の危険性がある。
(実メモリ-shared_buffers)/max_connectionsを超えるとだめ。
☆tcp_keepalives_idle = 60 # TCP_KEEPIDLE, in seconds;
# 0 selects the system default
コネクションを完全に接続するまでの待ち時間。
デフォルトが大きいので、確実な値を設定しておくのがベター。
tcp_keepalives_interval = 5 # TCP_KEEPINTVL, in seconds;
# 0 selects the system default
■BackGround Writer
BackGround Writerは、CheckPointが発生するまでに、
ディスク書き込みを少しでもしておくことで負荷の分散を計るもの。
負荷の分散が目的であり、処理量を減らすものではない。
アプリケーションで画面を表示するなどの場合、極端に遅いタイミングがあっては困るが
チェックポイントの書き込み量が多いときには、処理が極端に遅くなる可能性がある。
そういった場合に、BackGroundWriterによって、チェックポイントの書き込みが減るように
少しずつ書き込みをおこない、チェックポイント処理を軽減して、極端な処理落ちを防ぐことができる。(処理を分散するだけで、処理量を減らすものではない。)
逆に、大量データ処理の場合などは、負荷の分散よりも最終処理時間が大事なので、
チェックポイントに任せておいても問題ないと思われる。
(1回にたくさん書き込みしたほうがディスクアクセスを減らせるため)
その場合、チェックポイントとバキュームの発生タイミングなどのチューニングがむしろ重要だと考えられる。
☆bgwriter_delay = 5000ms # 10-10000ms between rounds
BackGroundWriterの実行間隔。
☆bgwriter_lru_maxpages = 1000 # 0-1000 max buffers written/round
BackGroundWriterが書込むサイズの最大値。
1バッファは8KB。
0にすると、BackGroundWriterを発生させない。
☆bgwriter_lru_multiplier = 10.0 # 0-10.0 multipler on buffers scanned/round
最近の周期で書き込んだ平均とこの値が掛け合わされて、BackGroundWriterが書込むサイズの最大値とする。なお、ここで算出した最大値とbgwriter_lru_maxpagesの小さいほうが採用される。
■WAL
☆wal_buffers = 64MB # min 32kB, -1 sets based on shared_buffers
# (change requires restart)
WAL=いわゆるトランザクションログをバッファリングしておく領域。
基本的には、コミットのときに、WALログファイルに書き込まれる。
その他、WALバッファがあふれたとき、Checkpoint、Vacuum実行時、WALライター実行時などにWALログファイルに書き込まれる。
多くの更新を実行するトランザクションがある場合は、WAL_Buffersは大きい目に設定しておいたほうが
ディスク書き込みを減らすことができる。
デフォルトの-1で、SharedBufferの1/32を割り当てる。
ただし、64KBから16MBの範囲内であり、それより大きい値を設定する場合は変えたほうがいい。
8.1まではバッファ指定だが、それ以降は、サイズ指定する。
☆wal_writer_delay = 200ms # 1-10000 milliseconds
WAL Writerの実行周期。
postgres.confで設定される。
多くのPostgresのチューニングパラメータは、一昔前のPCを意識したような設定値であり、
最近のPCスペックにあった設定をしておいたほうがいい。
■メモリ関連
☆shared_buffers = 2048MB # min 128kB
# (change requires restart)
表領域をキャッシュする領域。
たとえば、SELECTを実行するときに、この領域にデータがあれば
ディスクアクセスせずここのデータを読み書きする。
ディスクアクセス回数を減らすことができれば、処理が速くなる。
OSキャッシュとの兼ね合いもあるので、あまり大きくすることは推奨されない。
実メモリの25%がいいといわれている。
また、指定方法は古いバージョンではバッファ指定だったが、
最近のバージョンでは、バッファ指定できないようだ。
GB、MB、kBの単位で設定するようにする。
☆work_mem = 1MB # min 64kB
Postgresが処理に使うワーキングメモリ。
(実メモリ-shared_buffers)/max_connectionsを超えるとスワップするので注意。
☆maintenance_work_mem = 16MB # min 1MB
バキュームなどのメンテナンス処理に使われるワーキングメモリ。
少なすぎると、バキュームされないことがあるという人もいるが詳細不明。
■コネクション関連
☆max_connections = 300
work_memとの関係に注意。
work_memは接続ごとに発生するので、work_mem*max_connectionsのメモリを確保しておかないと、スワップ発生の危険性がある。
(実メモリ-shared_buffers)/max_connectionsを超えるとだめ。
☆tcp_keepalives_idle = 60 # TCP_KEEPIDLE, in seconds;
# 0 selects the system default
コネクションを完全に接続するまでの待ち時間。
デフォルトが大きいので、確実な値を設定しておくのがベター。
tcp_keepalives_interval = 5 # TCP_KEEPINTVL, in seconds;
# 0 selects the system default
■BackGround Writer
BackGround Writerは、CheckPointが発生するまでに、
ディスク書き込みを少しでもしておくことで負荷の分散を計るもの。
負荷の分散が目的であり、処理量を減らすものではない。
アプリケーションで画面を表示するなどの場合、極端に遅いタイミングがあっては困るが
チェックポイントの書き込み量が多いときには、処理が極端に遅くなる可能性がある。
そういった場合に、BackGroundWriterによって、チェックポイントの書き込みが減るように
少しずつ書き込みをおこない、チェックポイント処理を軽減して、極端な処理落ちを防ぐことができる。(処理を分散するだけで、処理量を減らすものではない。)
逆に、大量データ処理の場合などは、負荷の分散よりも最終処理時間が大事なので、
チェックポイントに任せておいても問題ないと思われる。
(1回にたくさん書き込みしたほうがディスクアクセスを減らせるため)
その場合、チェックポイントとバキュームの発生タイミングなどのチューニングがむしろ重要だと考えられる。
☆bgwriter_delay = 5000ms # 10-10000ms between rounds
BackGroundWriterの実行間隔。
☆bgwriter_lru_maxpages = 1000 # 0-1000 max buffers written/round
BackGroundWriterが書込むサイズの最大値。
1バッファは8KB。
0にすると、BackGroundWriterを発生させない。
☆bgwriter_lru_multiplier = 10.0 # 0-10.0 multipler on buffers scanned/round
最近の周期で書き込んだ平均とこの値が掛け合わされて、BackGroundWriterが書込むサイズの最大値とする。なお、ここで算出した最大値とbgwriter_lru_maxpagesの小さいほうが採用される。
■WAL
☆wal_buffers = 64MB # min 32kB, -1 sets based on shared_buffers
# (change requires restart)
WAL=いわゆるトランザクションログをバッファリングしておく領域。
基本的には、コミットのときに、WALログファイルに書き込まれる。
その他、WALバッファがあふれたとき、Checkpoint、Vacuum実行時、WALライター実行時などにWALログファイルに書き込まれる。
多くの更新を実行するトランザクションがある場合は、WAL_Buffersは大きい目に設定しておいたほうが
ディスク書き込みを減らすことができる。
デフォルトの-1で、SharedBufferの1/32を割り当てる。
ただし、64KBから16MBの範囲内であり、それより大きい値を設定する場合は変えたほうがいい。
8.1まではバッファ指定だが、それ以降は、サイズ指定する。
☆wal_writer_delay = 200ms # 1-10000 milliseconds
WAL Writerの実行周期。
2016年12月17日土曜日
ADempiereの受注伝票の操作と機能
ここでは、ADempiereの受注伝票の操作と機能についてご紹介します。
参考URL : http://www.adempiere.com/Sales_Processes

①伝票タイプの入力
ADempiereで受注伝票を新規に作成するときに、まず入力するのは、伝票タイプになります。
伝票タイプとは、受注伝票の処理、特に後続の伝票である出荷伝票や請求伝票、
入金伝票などとの関連処理を決定する重要な項目で
以下のような、さまざまな業務パターンを想定した伝票タイプが用意されています。
・提案伝票(Proposal)
・見積伝票(Quotation)
・標準受注(Standard Order)
・倉庫受注(Warehouse Order)
・信用受注(On Credit Order)
・POS受注(Point Of Sales)
・前受受注(Prepay Order)
※返品業務については、受注伝票でなく返品伝票(RMA)を使用します。
そして、これらの伝票タイプの違いは、以下のようになります。

詳細は、図中に記載していますが、簡潔にまとめるとすると、それぞれの伝票タイプの主な違いは、後続のどの伝票を自動で作成するかと、在庫の予約をおこなうかどうかと、取引先にひもづくかどうかの3点の違いになるかと思います。
そして、それを簡潔に表した図が以下になり、伝票タイプによって、後続のどの伝票を完成させるかの範囲が変わってくることがわかるかと思います。
※画像は、ADempiere.comのものです。

上記の図のように、伝票タイプが標準受注であれば、受注伝票を完成しても、出荷伝票や請求伝票、入金伝票などは、手動で入力していくことが基本になります。
これは、その名(標準受注)のとおり、受注伝票の標準的な入力の仕方で、後続伝票もそれぞれの業務にあわせて、ひとつひとつ手動で入力していくことになります。
(標準受注でも、実際には自動生成プロセス画面によって各伝票を作成できる。)
しかし、たとえば、POS受注の場合、受注伝票完成により、出荷、請求、入金までの処理が自動でおこなわれることになります。
これは、POSという業務を考えればわかりやすいと思いますが、
たとえば、コンビニのレジでジュースを買ったとき、コンビニ店の立場からみると、
顧客からの注文をもらい(受注)、商品(ジュース)を顧客に納品し(出荷)、
お買い上げ金額を伝え(請求)、お金を受け取る(入金)といった業務が一気におこなわれています。(これがPOSの業務)
これをシステム(ERP)における伝票という形で置き換えると、受注伝票、出荷伝票、請求伝票、入金伝票が一気に作成されることとなります。
このように、ADempiereでは、さまざまな業務を想定して、伝票タイプをあらかじめ用意しており
ここでは、POSについて詳しく説明しましたが、その他の提案伝票(Proposal)、見積伝票(Quotation)、倉庫受注(Warehouse Order)、信用受注(On Credit Order)、前受受注(Prepay Order)の伝票タイプについても、それぞれの業務パターンを想定してあらかじめ用意されています。
※在庫を持たない品目を登録して、サービス受注として受注伝票を作成することも可能です。
②取引先の入力
伝票タイプを入力した後、次に入力するのは、取引先です。
(ADempiereでは、伝票タイプによって入力項目が変わり画面表示が自動切換えされるため
伝票タイプによっては、取引先入力が不要のものがあったり、表示される項目に相違があるため、
前提条件として、ここからは、標準受注の伝票タイプを入力したものとして説明を続けます。)
取引先を選択することによって、取引先に設定されている情報が受注伝票の初期値として提案されます。
たとえば、ドル建ての取引先であれば、受注伝票の通貨がドル建てで初期値提案されたり、
支払い条件、支払い方法、出荷先住所や請求先住所など、取引先に設定されている情報が初期値として設定されます。(もちろん、伝票側で変更可能)
これによって、ユーザが手動で入力しなければいけない項目を大きく減らしています。
取引先から初期値提案される項目には、以下のようなものがあります。

③日付の入力
取引先を入力した後、次に入力するのは、日付です。(ごく基本的な入力手順では)
受注日、出荷予定日、納期などを入力します。
④品目と数量の入力
後は、明細で、品目と数量を入力します。
品目を選択時に、品目価格が自動で設定されたり、在庫があるかの確認がおこなわれたりもします。
このように、ADempiereの受注伝票は、ユーザの入力負担を減らして、効率的な入力が可能なように設計されています。
これができるのは、技術的には、ADempiereのDB設計における正規化や関連性がしっかりしており、マスタとの連携を効率的におこなえるような仕組みがあるから実現できています。
⑤伝票ステータスの更新
ADempiereの伝票には、ステータスというものがあり、これを完成することにより、受注伝票の完成処理がおこなわれます。
ステータスは、その受注伝票の状態をあらわしていて、たとえば作成中であれば、草案というステータスになっています。
<その他の受注伝票機能>
その他の機能としては、直送指定、プロジェクト管理(案件管理)、代理店、EDI連携、帳票出力、レポート出力、MRPへのインプットなどの機能があり、非常に豊富な機能が実装されています。
また、必要な項目は、ノンプログラミングで自由に追加することができますので、各業種、各会社にあった項目を後から追加できます。
さらに、表示、非表示の切り替え、表示位置の変更なども可能になっていますので、各社にあった項目や表示順で構成された受注伝票画面を構築することが可能になっています。
参考URL : http://www.adempiere.com/Sales_Processes

①伝票タイプの入力
ADempiereで受注伝票を新規に作成するときに、まず入力するのは、伝票タイプになります。
伝票タイプとは、受注伝票の処理、特に後続の伝票である出荷伝票や請求伝票、
入金伝票などとの関連処理を決定する重要な項目で
以下のような、さまざまな業務パターンを想定した伝票タイプが用意されています。
・提案伝票(Proposal)
・見積伝票(Quotation)
・標準受注(Standard Order)
・倉庫受注(Warehouse Order)
・信用受注(On Credit Order)
・POS受注(Point Of Sales)
・前受受注(Prepay Order)
※返品業務については、受注伝票でなく返品伝票(RMA)を使用します。
そして、これらの伝票タイプの違いは、以下のようになります。

詳細は、図中に記載していますが、簡潔にまとめるとすると、それぞれの伝票タイプの主な違いは、後続のどの伝票を自動で作成するかと、在庫の予約をおこなうかどうかと、取引先にひもづくかどうかの3点の違いになるかと思います。
そして、それを簡潔に表した図が以下になり、伝票タイプによって、後続のどの伝票を完成させるかの範囲が変わってくることがわかるかと思います。
※画像は、ADempiere.comのものです。

上記の図のように、伝票タイプが標準受注であれば、受注伝票を完成しても、出荷伝票や請求伝票、入金伝票などは、手動で入力していくことが基本になります。
これは、その名(標準受注)のとおり、受注伝票の標準的な入力の仕方で、後続伝票もそれぞれの業務にあわせて、ひとつひとつ手動で入力していくことになります。
(標準受注でも、実際には自動生成プロセス画面によって各伝票を作成できる。)
しかし、たとえば、POS受注の場合、受注伝票完成により、出荷、請求、入金までの処理が自動でおこなわれることになります。
これは、POSという業務を考えればわかりやすいと思いますが、
たとえば、コンビニのレジでジュースを買ったとき、コンビニ店の立場からみると、
顧客からの注文をもらい(受注)、商品(ジュース)を顧客に納品し(出荷)、
お買い上げ金額を伝え(請求)、お金を受け取る(入金)といった業務が一気におこなわれています。(これがPOSの業務)
これをシステム(ERP)における伝票という形で置き換えると、受注伝票、出荷伝票、請求伝票、入金伝票が一気に作成されることとなります。
このように、ADempiereでは、さまざまな業務を想定して、伝票タイプをあらかじめ用意しており
ここでは、POSについて詳しく説明しましたが、その他の提案伝票(Proposal)、見積伝票(Quotation)、倉庫受注(Warehouse Order)、信用受注(On Credit Order)、前受受注(Prepay Order)の伝票タイプについても、それぞれの業務パターンを想定してあらかじめ用意されています。
※在庫を持たない品目を登録して、サービス受注として受注伝票を作成することも可能です。
②取引先の入力
伝票タイプを入力した後、次に入力するのは、取引先です。
(ADempiereでは、伝票タイプによって入力項目が変わり画面表示が自動切換えされるため
伝票タイプによっては、取引先入力が不要のものがあったり、表示される項目に相違があるため、
前提条件として、ここからは、標準受注の伝票タイプを入力したものとして説明を続けます。)
取引先を選択することによって、取引先に設定されている情報が受注伝票の初期値として提案されます。
たとえば、ドル建ての取引先であれば、受注伝票の通貨がドル建てで初期値提案されたり、
支払い条件、支払い方法、出荷先住所や請求先住所など、取引先に設定されている情報が初期値として設定されます。(もちろん、伝票側で変更可能)
これによって、ユーザが手動で入力しなければいけない項目を大きく減らしています。
取引先から初期値提案される項目には、以下のようなものがあります。

③日付の入力
取引先を入力した後、次に入力するのは、日付です。(ごく基本的な入力手順では)
受注日、出荷予定日、納期などを入力します。
④品目と数量の入力
後は、明細で、品目と数量を入力します。
品目を選択時に、品目価格が自動で設定されたり、在庫があるかの確認がおこなわれたりもします。
このように、ADempiereの受注伝票は、ユーザの入力負担を減らして、効率的な入力が可能なように設計されています。
これができるのは、技術的には、ADempiereのDB設計における正規化や関連性がしっかりしており、マスタとの連携を効率的におこなえるような仕組みがあるから実現できています。
⑤伝票ステータスの更新
ADempiereの伝票には、ステータスというものがあり、これを完成することにより、受注伝票の完成処理がおこなわれます。
ステータスは、その受注伝票の状態をあらわしていて、たとえば作成中であれば、草案というステータスになっています。
<その他の受注伝票機能>
その他の機能としては、直送指定、プロジェクト管理(案件管理)、代理店、EDI連携、帳票出力、レポート出力、MRPへのインプットなどの機能があり、非常に豊富な機能が実装されています。
また、必要な項目は、ノンプログラミングで自由に追加することができますので、各業種、各会社にあった項目を後から追加できます。
さらに、表示、非表示の切り替え、表示位置の変更なども可能になっていますので、各社にあった項目や表示順で構成された受注伝票画面を構築することが可能になっています。
2016年12月10日土曜日
オートバキュームがされない原因は? (Postgres)
Postgresは、MVCC(多版式同時実行制御)の追記型なので、新規行作成(INSERT)だけでなく、
更新(UPDATE)の場合も内部では行データ(タプルという)が新たに増えていきます。
そのため、UPDATEを繰り返すだけでも、データがどんどん増えていき、
パフォーマンスが極端に落ちてしまうことがあります。
これを解決するために、Postgresでは、不要な行データを削除すること(バキュームという)が
必要となってきます。
昔は、バキュームコマンドを定期的に実行する必要がありましたが、
最近のPostgresでは、オートバキューム機能があるため、特に気にすることもなく、
勝手にバキュームしてくれます。
と、思っていましたが・・・
どういうわけか、担当プロジェクトの大量データ処理で激しい処理落ちが・・・
そして、原因調査へ
■まずは、バキューム関係のパラメータを設定
バキュームログを出力して、状況の詳細を確認する。
Postgres.confで、バキュームログを出力するように設定
autovacuum = on
log_autovacuum_min_duration = 0
※postgresの再起動が必要
※postgres.confは、デフォルトなら「C:\Program Files\PostgreSQL\9.x\data」にあるはず。
■ログの確認
そして、再実行して、処理落ちがはじまったところでログを見てみると

やはり、タプルが残っていて、バキュームされていないように見える。
※このテーブル「ad_sequence」の実際の行は1479行であり、それに対してタプルが多すぎる。
※Postgresのログは、デフォルトなら「C:\Program Files\PostgreSQL\9.x\data\pg_log」に
日時付ファイル名で出力されている。
■さらに、PGAdminで、タプル状態の確認

これを見ても、やはり、タプルが残っているようだ。
■いろいろググッてみると、
Let's Postgresの以下のサイトを見つけた。
HOT(Heap Only Tuples) ~ Let's Postgres
HOT(Heap Only Tuple)といわれる機能があって、バキューム処理をしてくれるらしいのだが・・・
だけど、処理が激落ちしているので、それすら走っていない気がする。
そして、さらに上記サイトを読み進めていくと
ロングトランザクションに気をつけようということにひっかかる。
■ロングトランザクションとコネクションプールに注意!!!
改めて、ソースを確認していくとなんとコミット漏れがあり
それをコミットすることで状況は無事解決した。
(めでたし、めでたし、苦労のわりには、原因はイージーミスという情けない幕切れ。)
実行中のトランザクションで、更新されたテーブルは
そのトランザクションが終了するまでバキュームされないようだ。
ここでもうひとつ注意が必要なのは、コネクションプールについてである。
コネクションプールを使っていると、トランザクションがコミットされていても
バキュームされないことがあるようだ。
詳細不明だが、コネクションプールの機能は、プログラムからコネクションをクローズしても
物理的なコネクションはクローズされず、ある程度の期間(KeepAlive)、
コネクションを保持したり、使いまわしをするもののため、
そのKeepAliveの間は解放されないのではないかと推測しています。
なので、大量データ処理では、コネクションプールを使わず、コネクションの時間的コストはかかるが、適度なタイミングで、コネクションを解放して、再接続をしたほうがいいという結論に至りました。
更新(UPDATE)の場合も内部では行データ(タプルという)が新たに増えていきます。
そのため、UPDATEを繰り返すだけでも、データがどんどん増えていき、
パフォーマンスが極端に落ちてしまうことがあります。
これを解決するために、Postgresでは、不要な行データを削除すること(バキュームという)が
必要となってきます。
昔は、バキュームコマンドを定期的に実行する必要がありましたが、
最近のPostgresでは、オートバキューム機能があるため、特に気にすることもなく、
勝手にバキュームしてくれます。
と、思っていましたが・・・
どういうわけか、担当プロジェクトの大量データ処理で激しい処理落ちが・・・
そして、原因調査へ
■まずは、バキューム関係のパラメータを設定
バキュームログを出力して、状況の詳細を確認する。
Postgres.confで、バキュームログを出力するように設定
autovacuum = on
log_autovacuum_min_duration = 0
※postgresの再起動が必要
※postgres.confは、デフォルトなら「C:\Program Files\PostgreSQL\9.x\data」にあるはず。
■ログの確認
そして、再実行して、処理落ちがはじまったところでログを見てみると

やはり、タプルが残っていて、バキュームされていないように見える。
※このテーブル「ad_sequence」の実際の行は1479行であり、それに対してタプルが多すぎる。
※Postgresのログは、デフォルトなら「C:\Program Files\PostgreSQL\9.x\data\pg_log」に
日時付ファイル名で出力されている。
■さらに、PGAdminで、タプル状態の確認

これを見ても、やはり、タプルが残っているようだ。
■いろいろググッてみると、
Let's Postgresの以下のサイトを見つけた。
HOT(Heap Only Tuples) ~ Let's Postgres
HOT(Heap Only Tuple)といわれる機能があって、バキューム処理をしてくれるらしいのだが・・・
だけど、処理が激落ちしているので、それすら走っていない気がする。
そして、さらに上記サイトを読み進めていくと
ロングトランザクションに気をつけようということにひっかかる。
■ロングトランザクションとコネクションプールに注意!!!
改めて、ソースを確認していくとなんとコミット漏れがあり
それをコミットすることで状況は無事解決した。
(めでたし、めでたし、苦労のわりには、原因はイージーミスという情けない幕切れ。)
実行中のトランザクションで、更新されたテーブルは
そのトランザクションが終了するまでバキュームされないようだ。
ここでもうひとつ注意が必要なのは、コネクションプールについてである。
コネクションプールを使っていると、トランザクションがコミットされていても
バキュームされないことがあるようだ。
詳細不明だが、コネクションプールの機能は、プログラムからコネクションをクローズしても
物理的なコネクションはクローズされず、ある程度の期間(KeepAlive)、
コネクションを保持したり、使いまわしをするもののため、
そのKeepAliveの間は解放されないのではないかと推測しています。
なので、大量データ処理では、コネクションプールを使わず、コネクションの時間的コストはかかるが、適度なタイミングで、コネクションを解放して、再接続をしたほうがいいという結論に至りました。
2016年10月11日火曜日
Jasperで画像データ(Imageデータ)をDBから表示する方法
JapserReportでは、画像データ(Imageデータ)を出力することができるが、
DBに格納された画像データを出力する場合、少し工夫が必要のようだ。
ここでは、Postgresのbytea型に画像データが入っているとする。
そのデータをJasperReportで画像として出力する。


DBに格納された画像データを出力する場合、少し工夫が必要のようだ。
ここでは、Postgresのbytea型に画像データが入っているとする。
そのデータをJasperReportで画像として出力する。
ここで、ポイントとなるのが、JasperReportからbytea列をSQLで取得したときに
果たして、どういう型で取得されるのかということである。
結論から言うと、実はbytea列がどの型で取得されるかが、DB接続に使用しているAPIによって、違うということだ。
そのため、ADempiereなどのアプリケーションからはうまく画像表示できるのに、
iReport上で実行してみると画像表示できないといったことが発生する。
これは、ADempiereのアプリから実行されるAPIとiReportから実行されるAPIで
bytea列型の扱い方法が違うから発生していると思われる。
これを解決するためには、byteaの列をBase64エンコードして、テキストデータとして扱うことがポイントである。
こうすることで、APIの仕様にかかわらず画像データをテキストデータとして扱うことが可能であり、iReport上からも、ADempiereなどのアプリケーションからも画像データを出力することが可能となる。
以下が設定方法である。
■SQLでバイナリデータ取得
☆byteaの列をBase64でエンコードして、テキストデータとして取り出す。
以下のSMB_QRCode_DocNoは、bytea型でPostgresに定義されている。
以下のSQLで、Base64でエンコードしてテキストデータとしている。
SELECT encode(cf.SMB_QRCode_DocNo::bytea, 'base64') AS SMB_QRCode_DocNo
FROM M_InOutConfirm cf
・・・・
※Edit Queryダイアログで、表示される該当バイナリ列(SMB_QRCode_DocNo)のDataTypeが「java.lang.String」であることを確認しておく。
■イメージオブジェクトの設定
①ImageExpressionプロパティに以下を設定。
new java.io.ByteArrayInputStream(javax.xml.bind.DatatypeConverter.parseBase64Binary((String)$F{smb_qrcode_docno}))
※DBから取得したBase64のテキストをByte配列にコンバートし、それを引数にInputStreamを作成している。

②Expressionクラス
java.io.InputStreamを選択する。
※①の戻り値の型のため
③以下は念のため設定しておく
UsingCacheプロパティ:チェックしておく。
On Error Type:Blank
2016年10月9日日曜日
中小企業のITシステム導入 ~中小企業白書2016年度版より②
前ページに引き続き、2016年度版の中小企業白書からいくつかピックアップして、中小企業のITシステム導入について考察したいと思います。
参考:2016年度版 中小企業白書 第2部 第2章 中小企業におけるITの利活用
http://www.chusho.meti.go.jp/pamflet/hakusyo/H28/h28/index.html


参考:2016年度版 中小企業白書 第2部 第2章 中小企業におけるITの利活用
http://www.chusho.meti.go.jp/pamflet/hakusyo/H28/h28/index.html
■中小企業がIT投資を行わない理由
以下の統計では、現在IT投資を行っていない企業に対して、IT投資を行わない理由を調査しsています。
この結果は、とても意外でした。
IT投資を行っていない理由で最も多いのが「ITを導入できる人材がいない」ということのようです。
中小企業は、IT投資を重要視しているが、ITを導入するための人材がいなくて、
その効果がわからないために投資に踏み切れていない企業が多いようです。
コストの問題というより、むしろITに詳しい人材がいないということが理由のようです。

この結果からいえることは、中小企業がITシステム導入をするために、中小企業とシステム導入・開発会社を橋渡しする人材が必要ということではないでしょうか。
その人材を中小企業自らが内部に抱え込むのか、システム会社側にそういう人材が必要なのか、それともどちらにも属さない中立的な人材(ITコーディネータなど)がいいのかあると思いますが
まずは、そういう人材が必要であることがこの統計からは明らかだと思います。
少なからず、システム会社に属する我々がまずできることは、難しい横文字を使うのではなく、わかりやすくシステム導入について説明していくことが重要なことであるといえます。
■IT人材の活用
第3節の統計データからは、IT人材の活用方法についての統計データがあります。
ここでは、IT人材が不足しているという認識している企業が多く、
また、必要とする人材像が不明といった回答も多くみられています。
その中で、特筆すべきは、最後の統計データで、高収益企業は、外部人材を活用している割合が高いということかもしれません。
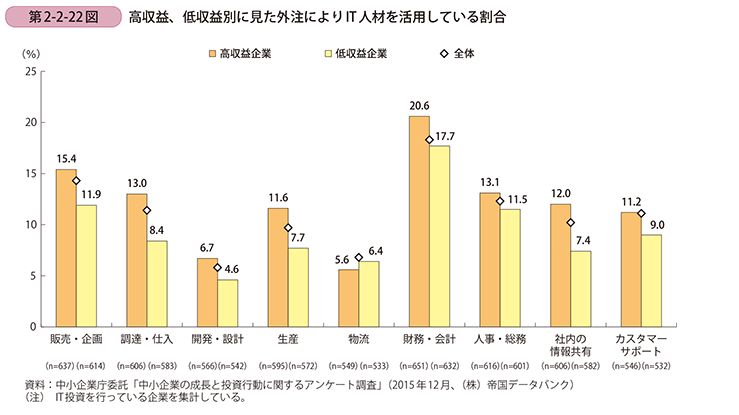
中小企業のITシステム導入 ~中小企業白書2016年度版より
2016年度版の中小企業白書からいくつかピックアップして、中小企業のITシステム導入について考察したいと思います。
参考:2016年度版 中小企業白書 第2部 第2章 中小企業におけるITの利活用
http://www.chusho.meti.go.jp/pamflet/hakusyo/H28/h28/index.html
■ITシステム導入と業績の関係
まず、2016年度版の中小企業白書によると、
IT投資を行っている企業の方が、行っていない企業に比べて売上高、売上高経常利益率といった企業の業績が高い傾向が強いという結果がでています。
積極的な投資をおこなうから、業績がいいのか、業績がいいから積極的な投資をおこなうのか、鶏が先か卵が先か的なところもあるかもですが(これについては次の分析結果参照)、
結果として、やはりIT投資を積極的に行った企業のほうが業績がいいということのようです。

色の濃いほうが、IT導入ありの企業の棒グラフですべての業種において、IT導入なしの企業を上回っています。
■ITシステム導入後の業績推移
次のグラフでは、2010年以降にITシステムを導入した企業の業績がどうなったかを表しています。
ITシステム導入によって、業績が上がっていることがみてとれるようです。


■業務領域におけるIT活用
次の統計では、業務領域ごとにパッケージソフトによる導入かオーダーメイドによる導入かなどのITシステムの導入方法が調査されています。
予想通り、財務・会計、人事・給与といった会社ごとにばらつきが少ない分野では
パッケージソフトが使用されており、販売管理や購買管理、生産管理といった分野では比較的パッケージソフトの利用が少ないことがわかります。
ただ、オーダーメイドのシステムを中小企業が導入するとなると、開発費がかなり高くなることから、オーダーメイドによる導入ができる中小企業は多くないと考えられます。そのため、自社の業務にあったパッケージソフトを見つけ、それを導入して、導入費を下げたいと思う中小企業も多いと考えられます。
そういう意味ではパッケージソフトの機能充実や柔軟なカスタマイズが求められていると思いますが、近年では、機能の充実したパッケージソフトや各社にあった設定を柔軟におこなうことのできるパッケージソフトが出てきており、パッケージソフトの今後に期待がかかっているのではないでしょうか。
このサイトで紹介しているオープンソース ERPであるADempiereもそのひとつといえます。
ADempiereでは、豊富な機能、柔軟な設定により、企業によって違いのあるような多様な業務にも対応が可能なつくりとなっており、導入コストの大幅な削減が可能となっております。


参考:2016年度版 中小企業白書 第2部 第2章 中小企業におけるITの利活用
http://www.chusho.meti.go.jp/pamflet/hakusyo/H28/h28/index.html
■ITシステム導入と業績の関係
まず、2016年度版の中小企業白書によると、
IT投資を行っている企業の方が、行っていない企業に比べて売上高、売上高経常利益率といった企業の業績が高い傾向が強いという結果がでています。
積極的な投資をおこなうから、業績がいいのか、業績がいいから積極的な投資をおこなうのか、鶏が先か卵が先か的なところもあるかもですが(これについては次の分析結果参照)、
結果として、やはりIT投資を積極的に行った企業のほうが業績がいいということのようです。

色の濃いほうが、IT導入ありの企業の棒グラフですべての業種において、IT導入なしの企業を上回っています。
■ITシステム導入後の業績推移
次のグラフでは、2010年以降にITシステムを導入した企業の業績がどうなったかを表しています。
ITシステム導入によって、業績が上がっていることがみてとれるようです。

■IT投資と従業者数の関係
ここでは、IT投資によって、従業員数がどう変化したかが調査されています。
この結果は、私としては意外な結果でした。
ITシステム導入により、従業員は減ってコスト削減するものと思っておりましたが、
意外とそうでもないようです。
理由は、業務効率化によって削減した人員を配置転換させるなどして、付加価値向上のための人材として活用することで、社内全体としては従業者数を変化させることなく、業績を向上させていることが推察されるようです。

■業務領域におけるIT活用
次の統計では、業務領域ごとにパッケージソフトによる導入かオーダーメイドによる導入かなどのITシステムの導入方法が調査されています。
予想通り、財務・会計、人事・給与といった会社ごとにばらつきが少ない分野では
パッケージソフトが使用されており、販売管理や購買管理、生産管理といった分野では比較的パッケージソフトの利用が少ないことがわかります。
ただ、オーダーメイドのシステムを中小企業が導入するとなると、開発費がかなり高くなることから、オーダーメイドによる導入ができる中小企業は多くないと考えられます。そのため、自社の業務にあったパッケージソフトを見つけ、それを導入して、導入費を下げたいと思う中小企業も多いと考えられます。
そういう意味ではパッケージソフトの機能充実や柔軟なカスタマイズが求められていると思いますが、近年では、機能の充実したパッケージソフトや各社にあった設定を柔軟におこなうことのできるパッケージソフトが出てきており、パッケージソフトの今後に期待がかかっているのではないでしょうか。
このサイトで紹介しているオープンソース ERPであるADempiereもそのひとつといえます。
ADempiereでは、豊富な機能、柔軟な設定により、企業によって違いのあるような多様な業務にも対応が可能なつくりとなっており、導入コストの大幅な削減が可能となっております。


2016年9月28日水曜日
ADempiereの読み取り専用ロジック
ADempiereでは、GUIから画面やテーブルを作成できる。
テーブルの列の設定では、その項目が読み取り専用かどうかを設定できる。
ここに、「Y」を設定すれば、読み取り専用の列となり、「N」を設定すれば更新可能な列となる。
さらに、応用的な設定方法としては、ここにちょっとしたロジックを記述して、
ある条件のときだけ、読み取り専用の列としたりすることも可能である。
このロジックを読み取り専用ロジックと呼んでいるが、
ここに設定するロジックでは、なんでも記述できるわけでないので注意が必要である。
このページの最後に、詳細な定義は記述したが、まとめると以下のようになる。
・コンテキストを使うときは、普通に記述できる。
ex. @C_BPartner_ID@
・かつ条件とまたは条件は、「&」「|」のひとつでいい。
このへんは、Javaだと「&&」「||」なので、注意が必要。
・「=」の反対の「~でない条件」は、「!」でいい。
これも、ちょっと変わっているので注意が必要。(「!=」でもなく、「<>」でもなく、「!」だけ)
ex. @C_BPartner_ID@!0
・右辺でコンテキストは使えない。(コンテキスト同士の比較はできない)
@C_BPartner_ID@=@C_BPartner2_ID@ みたいなことはできないようだ。
・結局、サンプルにあるように
Example '@AD_Table@=Test | @Language@=GERGER
のような条件式が適当な使い方になりそう。
複雑なロジックを使う場合は、新たな列を使って、その列にロジックを埋め込んで、その結果を読み取り専用ロジックで使うといったやり方になりそう。
詳細は、以下。
=========================================================
http://wiki.adempiere.net/Read_Only_Logic
=========================================================
The content here is parsed by the AD engine as stated in the APIdoc of the code for ReadOnlyLogic (GridTab.isReadOnly() - Boolean evaluateLogic):
* Evaluate Logic.
* <code>
* format := <expression> [<logic> <expression>]
* expression := @<context>@<exLogic><value>
* logic := <|> | <&>
* exLogic := <=> | <!> | <^> | <<> | <>>
*
* context := any global or window context
* value := strings can be with ' or "
* logic operators := AND or OR with the prevoius result from left to right
*
* Example '@AD_Table@=Test | @Language@=GERGER
* </code>
* @param source class implementing get_ValueAsString(variable)
* @param logic logic string
* @return logic result
テーブルの列の設定では、その項目が読み取り専用かどうかを設定できる。
ここに、「Y」を設定すれば、読み取り専用の列となり、「N」を設定すれば更新可能な列となる。
さらに、応用的な設定方法としては、ここにちょっとしたロジックを記述して、
ある条件のときだけ、読み取り専用の列としたりすることも可能である。
このロジックを読み取り専用ロジックと呼んでいるが、
ここに設定するロジックでは、なんでも記述できるわけでないので注意が必要である。
このページの最後に、詳細な定義は記述したが、まとめると以下のようになる。
・コンテキストを使うときは、普通に記述できる。
ex. @C_BPartner_ID@
・かつ条件とまたは条件は、「&」「|」のひとつでいい。
このへんは、Javaだと「&&」「||」なので、注意が必要。
・「=」の反対の「~でない条件」は、「!」でいい。
これも、ちょっと変わっているので注意が必要。(「!=」でもなく、「<>」でもなく、「!」だけ)
ex. @C_BPartner_ID@!0
・右辺でコンテキストは使えない。(コンテキスト同士の比較はできない)
@C_BPartner_ID@=@C_BPartner2_ID@ みたいなことはできないようだ。
・結局、サンプルにあるように
Example '@AD_Table@=Test | @Language@=GERGER
のような条件式が適当な使い方になりそう。
複雑なロジックを使う場合は、新たな列を使って、その列にロジックを埋め込んで、その結果を読み取り専用ロジックで使うといったやり方になりそう。
詳細は、以下。
=========================================================
http://wiki.adempiere.net/Read_Only_Logic
=========================================================
The content here is parsed by the AD engine as stated in the APIdoc of the code for ReadOnlyLogic (GridTab.isReadOnly() - Boolean evaluateLogic):
* Evaluate Logic.
* <code>
* format := <expression> [<logic> <expression>]
* expression := @<context>@<exLogic><value>
* logic := <|> | <&>
* exLogic := <=> | <!> | <^> | <<> | <>>
*
* context := any global or window context
* value := strings can be with ' or "
* logic operators := AND or OR with the prevoius result from left to right
*
* Example '@AD_Table@=Test | @Language@=GERGER
* </code>
* @param source class implementing get_ValueAsString(variable)
* @param logic logic string
* @return logic result
2016年3月13日日曜日
ADempiere.comのURLが変わったようです
これまで、ADempiereの使い方やインストール方法、開発方法など、
たくさんの情報が掲載されていた「ADempiere.com」だが、
アクセスしてみると、なにやら意味深なアナウンスが載っている状態だ。
どうやら、ADempiere.netに完全に移動されるようだ。
これまでのWiki情報は、「http://wiki.adempiere.net/」で無事に表示された。
しかし、adempiere.netはまだリンク切れが多い状態のようだ。
とりあえず、wikiの情報が見れるようなので影響は少なそうだ。
<詳細> ~http://wiki.adempiere.net/ADempiere_ERPの文言より
もともと、ADempiere.comは、1企業が所有するドメインのため、今回のようなことになったよう。
1企業の政治的、戦略的な理由で、ドメインが閉鎖されることがあるということ。
これは、商業的な理由で、これまでのコミュニティの資産がゼロになってしまうリスクがあるということ。
そのため、商業企業でもなく、利益ももとめない個人の集まりであるADempiereCommunityが
これを保持したほうがいいとの考えから、ADempiere.netは、ADempiereCommunityが保持することになったようだ。
たくさんの情報が掲載されていた「ADempiere.com」だが、
アクセスしてみると、なにやら意味深なアナウンスが載っている状態だ。
どうやら、ADempiere.netに完全に移動されるようだ。
これまでのWiki情報は、「http://wiki.adempiere.net/」で無事に表示された。
しかし、adempiere.netはまだリンク切れが多い状態のようだ。
とりあえず、wikiの情報が見れるようなので影響は少なそうだ。
<詳細> ~http://wiki.adempiere.net/ADempiere_ERPの文言より
もともと、ADempiere.comは、1企業が所有するドメインのため、今回のようなことになったよう。
1企業の政治的、戦略的な理由で、ドメインが閉鎖されることがあるということ。
これは、商業的な理由で、これまでのコミュニティの資産がゼロになってしまうリスクがあるということ。
そのため、商業企業でもなく、利益ももとめない個人の集まりであるADempiereCommunityが
これを保持したほうがいいとの考えから、ADempiere.netは、ADempiereCommunityが保持することになったようだ。
2016年1月18日月曜日
Gitサイズが大きいレポジトリのクローンエラー①
Gitサイズが大きいときのクローンでは、エラーが発生することがある。
remote: Counting objects: 13751, done.
remote: Compressing objects: 78% (2213error: git upload-pack: git-pack-objects died with error.
fatal: git upload-pack: aborting due to possible repository corruption on the remote side.
remote: warning: suboptimal pack - out of memory
remote: fatal: Out of memory, malloc failed
remote: aborting due to possible repository corruption on the remote side.
fatal: protocol error: bad pack header
git did not exit cleanly (exit code 128) (2403 ms @ 2016/01/18 18:39:49)
その場合、以下のように、depth=1で1回Cloneしたあと、Fetchすると取得できるようだ。
以下のコマンドでもできるが、トータスGitなどを使えば、 GUIからも可能。
コマンド例
git clone --depth 1 http://hoge.com/hoge.git
git fetch --depth 5
git fetch --depth 20
git fetch --unshallow
また、サーバ側での設定を変えることで対応することもできる。
サーバ側のConfigファイルに以下の設定をする。
(pack配下だけでいいかも。値はサーバに応じて設定)
[core]
packedGitLimit = 4000m
packedGitWindowSize = 1000m
[pack]
windowMemory = 4000m
SizeLimit = 4000m
threads = 1
window = 0
remote: Counting objects: 13751, done.
remote: Compressing objects: 78% (2213error: git upload-pack: git-pack-objects died with error.
fatal: git upload-pack: aborting due to possible repository corruption on the remote side.
remote: warning: suboptimal pack - out of memory
remote: fatal: Out of memory, malloc failed
remote: aborting due to possible repository corruption on the remote side.
fatal: protocol error: bad pack header
git did not exit cleanly (exit code 128) (2403 ms @ 2016/01/18 18:39:49)
その場合、以下のように、depth=1で1回Cloneしたあと、Fetchすると取得できるようだ。
以下のコマンドでもできるが、トータスGitなどを使えば、 GUIからも可能。
コマンド例
git clone --depth 1 http://hoge.com/hoge.git
git fetch --depth 5
git fetch --depth 20
git fetch --unshallow
また、サーバ側での設定を変えることで対応することもできる。
サーバ側のConfigファイルに以下の設定をする。
(pack配下だけでいいかも。値はサーバに応じて設定)
[core]
packedGitLimit = 4000m
packedGitWindowSize = 1000m
[pack]
windowMemory = 4000m
SizeLimit = 4000m
threads = 1
window = 0
2015年12月30日水曜日
ADempiereのMRPの実力
オープンソースERPのADempiereには、強力で実用的なMRP機能が備わっていますが、
何がどこまでできるのかその実態をまとめてみたいと思います。
また、ここでは、ADempiereのオリジナルとしてもともと実装されている機能をまず紹介し
それに加えて、SMBアソシエイツ株式会社により、追加実装した機能を紹介したいと思います。
■オリジナル機能
ADempiereのLibero Manufacturingにもともと実装され動作している機能の主なものは以下のとおりです。
・MRPの基本機能
受注による所要、先行生産による所要、在庫量、仕掛量、安全在庫などを考慮して、正味所要量計算をおこないます。
生産の必要があれば製造指図伝票を作成し、購買の必要があれば購買依頼伝票を作成します。
また、製造指図伝票を作成した場合、その指図で生産される製品の構成品(BOM)から、下位部品や原材料への所要を発生させます。
下位部品や原材料についても同様に正味所要量計算をおこない、必要があれば製造指図や購買依頼を発生させます。
・先行生産
受注に依存しない独立所要を登録する方法と
受注伝票の伝票タイプとして実装する方法があります。
受注はなくても、生産を先行して行いたいケースに利用できます。
・注文パック数量
受注などから発生した需要をこの単位で認識するよう設定できます。
ex.
10個の注文があるが、100個単位の需要として処理するなど。
・注文最大数量
いわゆるバッチ生産数量。
正味所要量計算の結果、算出された生産量がこの値より小さい場合、この数量単位での生産が提案されます。
ある機械を稼動すれば必ず100個単位で生産される場合や、
ある製品は10個20個といった少ない単位では生産せず、300個単位でしか生産しないといった場合に
この値を利用することができます。
・安全在庫量
MRPパラメータとして設定できる。
主に定量発注品などに利用。
・MRP対象期間
MRPの対象となる期間を設定できます。
ex.
未来30日までの所要(受注)だけを対象とするなど。
(30日後以降の受注予定があっても対象としない)
・歩留まり考慮
歩留まり率、歩留まり量を考慮した生産量が提案されます。
・生産リードタイム考慮
生産リードタイムを考慮した、日程を提案します。
・配送日数考慮
配送日数を考慮したリードタイムを計算し、日程を提案します。
・原価計算
工程ごとの作業実績に応じた自動原価計算がおこなわれます。
標準原価計算として、各工程の直接労務費や間接費、その他経費を登録することで自動で工程にかかったコストが計算されます。
また、品目に対して標準原価を登録しておくことで、各工程のコストとの差異が計算され、記録されます。
・MRPのまわしかた
どこ(倉庫)でまわすのか?
どうまわすのか?(MRPリソース)の2つにより、
対象となる製品のBOMが決定され、この組み合わせに対するMRPパラメータを設定できます。
この設計には、知識とテクニックが必要ですが、
要はADempiereのMRPは、設定しだいでMRPのまわしかた、MRPの対象をいろいろと変更できる柔軟性をもっているということです。
各社のMRP運営方法(いつまわすのか、どの頻度でまわすのか、どの部署の誰がまわすのかなど)によってさまざまな設定方法が可能でそれぞれの要件によって決定されていきます。
ex.
前工程だけでまわす、後工程だけでまわす、特定の製品だけでまわす、あるときは別工場で生産するように設定してまわしてみるなど
■独自追加機能
上記に加えて、SMBアソシエイツ(株)では、ADempiereのオリジナルのMRP機能を拡張しています。
(2015年12月現在のもの、今後も随時機能追加予定)
ここでは、そのリストをまず紹介します。
詳細は、別の記事で詳しく紹介していく予定です。
・バッチ生産に対応した指図の分割
・複数工場(マルチプラント)での生産計画の自動認識による所要量計算
・工程ごとの能力を考慮した生産リードタイム計算と負荷積上計算
・工程ごとの稼働日、非稼働日を考慮した生産計画日程の提案
・工程外注への対応
・取引先、出荷先、品目などの組み合わせに対応した配送日数の設定
・複数ロットへの払い出し
・各工程の詳細作業結果など入力機能
・構成品の払い出しロット選択と管理
・構成品の払い出しロットの結合、分割
・安全在庫計算の適正化

何がどこまでできるのかその実態をまとめてみたいと思います。
また、ここでは、ADempiereのオリジナルとしてもともと実装されている機能をまず紹介し
それに加えて、SMBアソシエイツ株式会社により、追加実装した機能を紹介したいと思います。
■オリジナル機能
ADempiereのLibero Manufacturingにもともと実装され動作している機能の主なものは以下のとおりです。
・MRPの基本機能
受注による所要、先行生産による所要、在庫量、仕掛量、安全在庫などを考慮して、正味所要量計算をおこないます。
生産の必要があれば製造指図伝票を作成し、購買の必要があれば購買依頼伝票を作成します。
また、製造指図伝票を作成した場合、その指図で生産される製品の構成品(BOM)から、下位部品や原材料への所要を発生させます。
下位部品や原材料についても同様に正味所要量計算をおこない、必要があれば製造指図や購買依頼を発生させます。
・先行生産
受注に依存しない独立所要を登録する方法と
受注伝票の伝票タイプとして実装する方法があります。
受注はなくても、生産を先行して行いたいケースに利用できます。
・注文パック数量
受注などから発生した需要をこの単位で認識するよう設定できます。
ex.
10個の注文があるが、100個単位の需要として処理するなど。
・注文最大数量
いわゆるバッチ生産数量。
正味所要量計算の結果、算出された生産量がこの値より小さい場合、この数量単位での生産が提案されます。
ある機械を稼動すれば必ず100個単位で生産される場合や、
ある製品は10個20個といった少ない単位では生産せず、300個単位でしか生産しないといった場合に
この値を利用することができます。
・安全在庫量
MRPパラメータとして設定できる。
主に定量発注品などに利用。
・MRP対象期間
MRPの対象となる期間を設定できます。
ex.
未来30日までの所要(受注)だけを対象とするなど。
(30日後以降の受注予定があっても対象としない)
・歩留まり考慮
歩留まり率、歩留まり量を考慮した生産量が提案されます。
・生産リードタイム考慮
生産リードタイムを考慮した、日程を提案します。
・配送日数考慮
配送日数を考慮したリードタイムを計算し、日程を提案します。
・原価計算
工程ごとの作業実績に応じた自動原価計算がおこなわれます。
標準原価計算として、各工程の直接労務費や間接費、その他経費を登録することで自動で工程にかかったコストが計算されます。
また、品目に対して標準原価を登録しておくことで、各工程のコストとの差異が計算され、記録されます。
・MRPのまわしかた
どこ(倉庫)でまわすのか?
どうまわすのか?(MRPリソース)の2つにより、
対象となる製品のBOMが決定され、この組み合わせに対するMRPパラメータを設定できます。
この設計には、知識とテクニックが必要ですが、
要はADempiereのMRPは、設定しだいでMRPのまわしかた、MRPの対象をいろいろと変更できる柔軟性をもっているということです。
各社のMRP運営方法(いつまわすのか、どの頻度でまわすのか、どの部署の誰がまわすのかなど)によってさまざまな設定方法が可能でそれぞれの要件によって決定されていきます。
ex.
前工程だけでまわす、後工程だけでまわす、特定の製品だけでまわす、あるときは別工場で生産するように設定してまわしてみるなど
■独自追加機能
上記に加えて、SMBアソシエイツ(株)では、ADempiereのオリジナルのMRP機能を拡張しています。
(2015年12月現在のもの、今後も随時機能追加予定)
ここでは、そのリストをまず紹介します。
詳細は、別の記事で詳しく紹介していく予定です。
・バッチ生産に対応した指図の分割
・複数工場(マルチプラント)での生産計画の自動認識による所要量計算
・工程ごとの能力を考慮した生産リードタイム計算と負荷積上計算
・工程ごとの稼働日、非稼働日を考慮した生産計画日程の提案
・工程外注への対応
・取引先、出荷先、品目などの組み合わせに対応した配送日数の設定
・複数ロットへの払い出し
・各工程の詳細作業結果など入力機能
・構成品の払い出しロット選択と管理
・構成品の払い出しロットの結合、分割
・安全在庫計算の適正化

2015年12月12日土曜日
ADempiere 会計仕訳の勘定科目表(備忘録)
ADempiereでどのタイミングで、どの勘定科目が使われて仕訳が作成されるかが表にまとめられています。
データベースとの対比がよくわかります。
http://www.adempiere.com/ADempiere_Accounting
データベースとの対比がよくわかります。
http://www.adempiere.com/ADempiere_Accounting
2015年10月27日火曜日
BigDecimalの落とし穴
BigDecimalの比較をおこなうときは、注意が必要。
BigDecimal bigA = new BigDecimal(0.00);
if( bigA == BigDecimal.ZERO )
{
System.out.println("bigA=ZERO");
}
else
{
System.out.println("bigA is not ZERO");
}
実行結果:bigA is not ZERO
上記の条件式「bigA == BigDecimal.ZERO」は、falseとなります。
「==」演算子で比較をおこなうと、BigDecimalの「0.00」と「0」は、違うものと判断されました。
BigDecimalの値そのものを比較したい場合は、CompareToメソッドを使わなければなりません。
BigDecimal bigA = new BigDecimal(0.00);
if( bigA == BigDecimal.ZERO )
{
System.out.println("bigA=ZERO");
}
else
{
System.out.println("bigA is not ZERO");
}
実行結果:bigA is not ZERO
上記の条件式「bigA == BigDecimal.ZERO」は、falseとなります。
「==」演算子で比較をおこなうと、BigDecimalの「0.00」と「0」は、違うものと判断されました。
BigDecimalの値そのものを比較したい場合は、CompareToメソッドを使わなければなりません。
登録:
投稿 (Atom)